 Auto
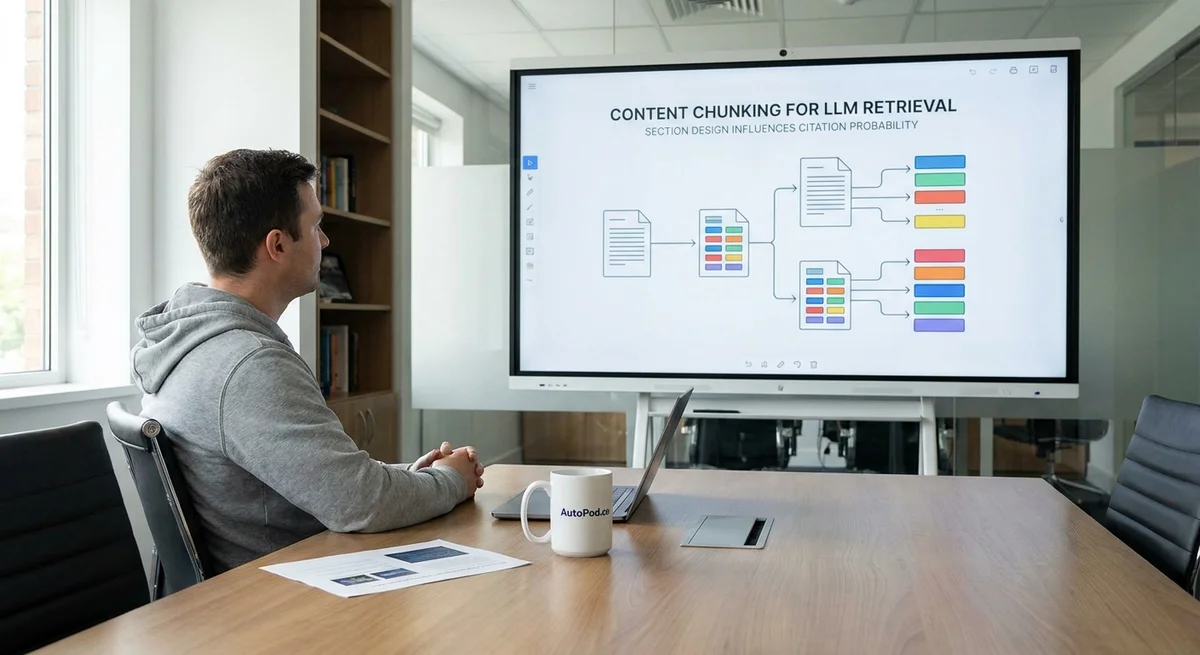
Розбиття контенту на фрагменти для вибірки LLM: Як дизайн розділів впливає на ймовірність цитування
Від Софії Мендес, Керівника відділу голосу бренду та автентичності
Знімок дослідження: 23 жовтня 2026 року
Сторінку не потрібно розбивати на дрібні шматочки, щоб вона зайняла місце у відповіді ШІ. Але її ідеї мають бути легкими для пошуку, розуміння та цитування.
У цьому полягає корисна відмінність. Гарний дизайн розділів може зробити контент зрозумілішим для людей та систем вибірки. Він не гарантує, що пошукова система ШІ процитує сторінку. Не існує доведеного правила 80–120 слів для отримання цитат.
Примітка щодо запиту на A/B-тестування: Я не змогла провести живий тест для цієї статті. Не було надано жодного вебсайту, опублікованих варіантів сторінок, пошукового облікового запису чи тестових запитів. Тому ця стаття не містить вигаданих результатів. Вона пояснює, що підтримує поточне дослідження, і описує тест, який може провести власник сайту.
По-перше, розмежуйте вибірку та індексування
«Пошук ШІ» може здаватися єдиною системою, але між публікацією сторінки та її цитуванням є кілька кроків:
- Сканування: Пошукова система або бот може отримати доступ до сторінки.
- Індексування: Система зберігає та обробляє сторінку.
- Вибірка: Пошукова або ШІ-система знаходить сторінку — або її частину — для відповіді на запитання.
- Цитування: Відповідь включає сторінку як джерело.
Дизайн розділів може допомогти системі зрозуміти та витягти відповідний уривок. Але він не може виправити сторінку, яка заблокована для сканування, ніколи не індексувалася або є менш корисною, ніж інші джерела. Google стверджує, що сторінки повинні бути проіндексовані та відповідати вимогам для появи зі сніпетом, перш ніж вони зможуть бути підтримуючими посиланнями в його функціях ШІ — і навіть відповідні сторінки не гарантовано з'являться. (developers.google.com)
Це важливо, оскільки точність сніпета та вибір цитування є різними результатами. Система може витягти чіткий уривок з вашої сторінки, але процитувати інше джерело. Або вона може процитувати вашу сторінку, спираючись на інформацію з кількох розділів.
Що свідчать дані про довжину фрагментів
Дослідження RAG — систем, які витягують текст, перш ніж просити мовну модель відповісти — показують, що розмір фрагмента може мати значення. Але оптимальний розмір залежить від завдання.
Дослідження 2025 року тестувало фрагменти фіксованого розміру на кількох наборах даних для відповідей на запитання. Менші фрагменти, такі як 64 або 128 токенів, показали кращі результати на деяких запитаннях з короткими, прямими відповідями. Більші фрагменти часто були кращими, коли запитання вимагало більше контексту. Дослідження вимірювало токени в системі вибірки, а не розділи з кількістю слів на публічних вебсайтах. Воно не доводить, що розділи з 80–120 слів покращують цитування в Google, Bing або ChatGPT пошуку. (arxiv.org)
Інше дослідження, опубліковане в 2025 Findings of ACL, виявило, що важливим був спосіб групування ідей, а не лише довжина фрагмента. Його автори повідомили, що сама довжина фрагмента не передбачала безпосередньо якість вибірки чи відповіді. Це вказує на практичний урок: короткий розділ не є автоматично хорошим розділом. Він все ще повинен містити повну ідею. (aclanthology.org)
Існує також обмеження щодо того, що ці дослідження можуть нам сказати. Вони тестують дослідницькі системи з відомими моделями, наборами даних та налаштуваннями вибірки. Публічні пошукові продукти ШІ використовують власні системи, і їхні повні правила вибору не є публічними.
Що можуть — і чого не можуть — заголовки та якорі
Заголовки роблять сторінку легшою для сприйняття
Чіткі заголовки H2 та H3 повідомляють читачам, що охоплює кожен розділ. Вони також можуть допомогти системам зрозуміти, як пов’язані ідеї. Google стверджує, що ранжування уривків може ідентифікувати частини сторінки, що відповідають запиту. Керівництво для вебмайстрів Microsoft також рекомендує чітку структуру контенту та логічні рівні заголовків для контенту, який може підтримувати відповіді та цитування ШІ. Жодне джерело не надає формату заголовків, який гарантує вибір. (developers.google.com)
Корисний заголовок називає суть розділу. «Коли короткий розділ працює» є більш інформативним, ніж «Більше деталей». Але заголовки повинні описувати контент, а не повторювати пошукові фрази заради них самих.
Іменовані якорі – це корисні посилання, а не окремі сторінки
Ідентифікатор, такий як id="short-sections", дозволяє посиланню переходити до певного заголовка на сторінці. Це допомагає читачам ділитися або повертатися до розділу. Це не окрема, індексована сторінка для цього розділу. Google стверджує, що він зазвичай ігнорує фрагменти URL для сканування та індексування як окремий контент, підтримуючи при цьому фрагменти, що використовуються для посилання на контент всередині сторінки. (developers.google.com)
Тому використовуйте іменовані якорі для стабільної навігації. Не очікуйте, що посилання #section-name само по собі підвищить ймовірність цитування або прискорить індексування.
Чітке письмо перемагає хитру розмітку
Поточне керівництво Google є прямим: немає необхідності розбивати контент на крихітні фрагменти для ШІ, і немає ідеальної довжини сторінки. Організуйте сторінку для її читачів та предмету. Google також стверджує, що його функції ШІ покладаються на основні пошукові системи, а не на спеціальний формат фрагментації. (developers.google.com)
Це краще правило, ніж сліпе дотримання кількості слів.
Ідея 80–120 слів: корисний стандарт, а не правило ранжування
Розділ обсягом 80–120 слів може добре працювати, коли він повністю відповідає на одне запитання. Наприклад, він може сформулювати рекомендацію, пояснити, чому вона працює, і надати одне застереження.
Але примусове вміщення кожного розділу в цей діапазон може зробити статтю уривчастою. Деякі ідеї потребують короткої відповіді. Інші потребують опрацьованого прикладу, доказів або попередження, що змінює рекомендацію.
Розглядайте 80–120 слів як редакційну відправну точку — а не як SEO-поріг. Зберігайте розділ коротким, коли він викладає одну повну думку. Дозволяйте йому бути довшим, якщо скорочення призведе до втрати необхідного контексту.
Як провести достовірне A/B-тестування
Щоб протестувати ефект на публічному пошуку ШІ, вам потрібен живий сайт, доступ до інструментів індексування та фіксований набір запитань. Невеликий тест на двох сторінках може бути цікавим, але він не може відокремити ефекти макета від відмінностей у темі, авторитеті або часі сканування.
Порівняйте дві версії архітектури
Для першого тесту порівняйте ці два шаблони сторінок:
| Варіант | Структура сторінки |
|---|---|
| A: Модульні розділи | Розділи приблизно 80–120 слів, з описовими заголовками H2/H3 та іменованими якорями. Кожен розділ викладає одну повну думку. |
| B: Довші блоки | Довші розділи, наприклад 300–500 слів, з чіткими заголовками H2/H3 та якорями біля основних заголовків розділів. |
Діапазон 300–500 слів є запропонованим тестовим контролем, а не встановленим стандартом. Зберігайте основні факти, докази, приклади, шаблон сторінки, метадані та підтримку внутрішніх посилань якомога схожими.
Цей перший тест вимірює пакет дизайнерських рішень. Якщо Варіант А має більше розривів розділів і більше заголовків H3, ви не можете сказати, чи виникла будь-яка відмінність через кількість слів, заголовки або їх комбінацію. Щоб ізолювати ці фактори, проведіть другий тест, який змінює один елемент за раз — наприклад, збережіть фіксованими заголовки та розмітку якорів, змінюючи розриви абзаців.
Використовуйте два види тестування
1. Контрольований тест вибірки
Помістіть той самий вихідний текст у дві версії вашої власної системи вибірки або тестової системи, яку ви контролюєте. Зберігайте модель, налаштування пошуку та набір запитань фіксованими. Змінюйте лише спосіб розбиття тексту.
Це може перевірити, чи призводить один макет до кращої вибірки або більш точних відповідей всередині цієї системи. Це не говорить вам, що зробить публічний пошуковий продукт ШІ.
2. Тест на живому вебсайті
Публічні пошукові системи потребують живих сторінок, тому використовуйте відповідні, оригінальні сторінки, а не публікуйте ідентичні копії. З'єднуйте сторінки зі схожою аудиторією, складністю теми, віком та існуючою підтримкою сайту. Випадковим чином призначте одну сторінку в кожній парі Варіанту А, а іншу — Варіанту Б.
Зберігайте процес публікації чесним: використовуйте порівнянні шаблони сторінок, метадані, внутрішні посилання та час генерації карти сайту. Не просувайте один варіант інтенсивніше. Якщо сайт має лише кілька підходящих сторінок, розглядайте результат як невеликий пілотний проєкт, а не доказ.
Вимірюйте результати окремо
- Точність вилучення сніпета: Підготуйте запитання з відомими відповідями. Попросіть рецензентів перевірити, чи кожен сніпет або відповідь, згенерований ШІ, передає правильний факт без зміни його значення.
- Частота вибору цитування: Для кожного фіксованого запитання запишіть, чи з'являється цільова сторінка як цитата. Також запишіть, чи дійсно цитована сторінка підтверджує твердження.
- Час до індексування: Запишіть, коли кожна сторінка була опублікована, вперше просканована та вперше підтверджена як проіндексована. Регулярно перевіряйте статус і повідомляйте медіанний час, а також частку, яка все ще не була проіндексована наприкінці.
Час індексування потребує обережного підходу. Google рекомендує використовувати посилання, що скануються, та карти сайту для полегшення виявлення, але зазначає, що сканування та індексування не гарантуються. Його керівництво також зауважує, що оновлення після повторного сканування можуть зайняти час. Сторінки, не проіндексовані до кінця, слід повідомляти як ще не проіндексовані, а не тихо вилучати їх з результатів. (developers.google.com)
Використовуйте фіксований список запитів і повторюйте ті самі запитання в тих самих пошукових продуктах ШІ. Результати можуть змінюватися, тому зберігайте дату, платформу, запитання, відповідь та цитовані URL-адреси в журналі. Звіт Bing Webmaster Tools про продуктивність ШІ може показати, які сторінки сайту цитуються та як змінюється активність цитування. Bing застерігає, що зміни в цих показниках не свідчать про те, що одна редакція сторінки спричинила зміни. (bing.com)
Мої гіпотези — не результати тестування
Перед проведенням тесту я очікую:
- Точність сніпета може покращитися, коли розділ відповідає на одне ймовірне запитання, не втрачаючи необхідного контексту. Дослідження RAG підтримують тестування цієї ідеї, але не встановлюють її впливу на публічний пошук ШІ.
- Вибір цитування може змінитися мало — або зовсім ні. Чіткіший розділ може допомогти з розумінням, але рішення про цитування також залежить від запиту, конкуруючих джерел, а також від того, чи є сторінка доступною та релевантною. Google описує відповіді ШІ як такі, що спираються на пошукову вибірку та пов'язані запити, а не на фіксоване правило довжини розділу. (developers.google.com)
- Час до індексування може не покращитися лише через те, що розділи коротші. Сигнали виявлення та доступ для сканування є більш прямими речами для перевірки. Це обґрунтоване очікування, а не виміряний результат.
Практичний стандарт архітектури контенту
Для більшості сторінок засновників та продуктів я рекомендую це як корпоративний стиль, а не обіцянку більшої кількості цитувань:
- Одна сторінка, одна основна потреба читача. Зазначте, що сторінка допомагає читачеві зробити.
- Один чіткий H1. Зробіть основну тему очевидною.
- Використовуйте описові H2 та H3. Зробіть сторінку легкою для сканування, з заголовками в логічному порядку.
- Прагніть до однієї повної відповіді на розділ. Використовуйте 80–120 слів, якщо така довжина підходить. Зробіть довшим, якщо ідея потребує доказів, контексту або прикладу.
- Пишіть так, щоб кожен розділ міг існувати самостійно. Називайте продукт, людину або ідею замість використання невизначених слів, таких як «це» або «цей».
- Додайте стабільні, описові ідентифікатори до важливих заголовків. Використовуйте звичайні посилання, такі як
href="#short-sections"для навігації по сторінці — а не як твердження, що кожен фрагмент є новою сторінкою. - Зберігайте важливий текст доступним. Перевірте, чи можуть сканери дістатися до сторінки та чи доступний її основний контент як текст. Для ChatGPT Search, OpenAI ідентифікує OAI-SearchBot як пошуковий сканер і пояснює, що власники сайту можуть керувати його доступом через robots.txt. (developers.openai.com)
- Розміщуйте докази поруч із твердженням, яке вони підтверджують. Коротке твердження з прилеглим джерелом легше перевірити, ніж твердження, яке залежить від контексту за кілька розділів.
- Зберігайте точку зору власника. Чіткий макет не зробить загальний контент вартим цитування — або вартим прочитання.
Останній пункт легко пропустити. Автоматизація має заощаджувати час засновника, а не стирати причину, чому їхній контент відрізняється. Корисний робочий процес контенту може повторно використовувати чіткий бриф: Творець, Аудиторія та Смак. AutoPod використовує ці дані для керування статтями, зберігаючи точку зору власника в процесі. Система може організувати сторінку; розуміння все ще повинно надходити від людей, які знають продукт та клієнта.
Висновок: розробляйте для ясності, потім тестуйте
Короткі розділи, чіткі заголовки та іменовані якорі — це гарний дизайн сторінки. Вони не є перевіреним лайфхаком для цитування. Розділ на 80–120 слів є розумною відправною точкою, коли він виражає одну повну ідею, але довші розділи можуть бути доречними, коли читачеві потрібно більше контексту.
Створюйте сторінки, які люди можуть сканувати та яким можуть довіряти. Переконайтеся, що пошукові системи можуть отримати до них доступ. Потім перевірте, чи покращує модульний макет вилучення або цитування на ваших власних сторінках. Доки цей тест не буде проведено, чесна відповідь проста: **добре фрагментування варто тестувати, але правило 100 слів не є фактом.